Gescande PDF omzetten naar bewerkbare Word
Een scan waarin je geen tekst kunt selecteren, bestaat vaak uit afbeeldingen van pagina's. Tekstherkenning leest de Turkse en Engelse tekst in die afbeeldingen en zet die in een DOCX-bestand.
Tool openen: Gescande PDF omzetten naar bewerkbare Word
Stap voor stap
- Open de tool voor gescande documenten en kies de PDF of de afbeelding van het document.
- Kies Turks, Engels of beide, afhankelijk van de tekst in het document. De taal van de interface wijzigen voegt geen nieuwe taal toe aan de OCR.
- Kies bewerkbare Word als uitvoer en start de verwerking.
- Loop datums, bedragen, namen en leestekens in het tekstcontroleveld na. Heb je iets verbeterd, download dan het nieuwe bestand met de knop voor de gecorrigeerde Word.
Controleer het resultaat
Bewerkbare Word behoudt de originele tabellen, kolommen, lettertypen en pagina-opmaak niet één-op-één. Met de optie paginaweergave blijven pagina's afbeeldingen. Doorzoekbare PDF combineert de weergave met tekst zoeken; OCR-fouten zijn mogelijk.
Voorbeeld
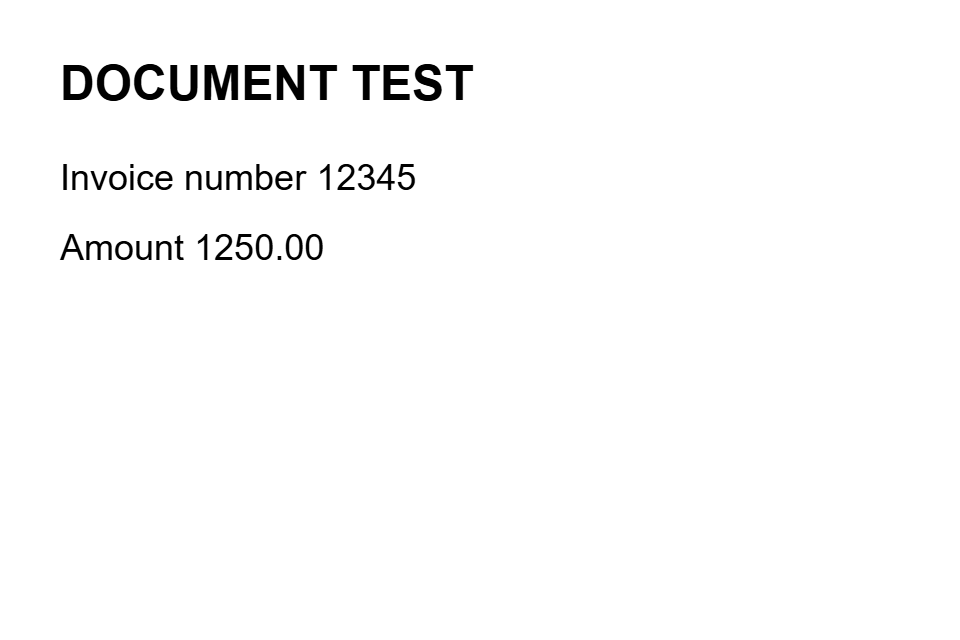
Voorbeeldcontrole: zorg dat het bedrag “1.250,00” in de scan niet als “1250,00” of “I.250,00” is gelezen. Gebruik liever een rechte, goed belichte scan dan een wazige foto.